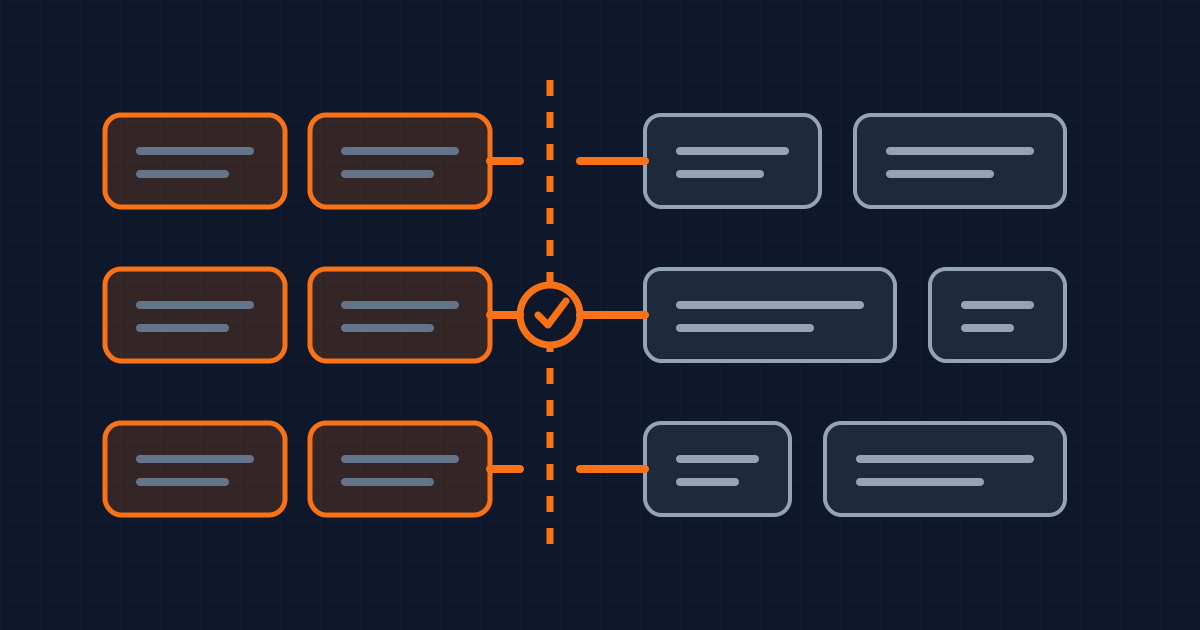
La caché empieza antes de llamar al modelo
Prompt caching suele tratarse como una opción de precio. En la práctica, es un contrato de serialización entre tu aplicación y el proveedor del modelo. Las instrucciones, herramientas y referencias reutilizables deben convertirse en el mismo prefijo antes de que la solicitud llegue al modelo.
Según la revisión del 30 de septiembre de 2026, la documentación de prompt caching de OpenAI indica que la reutilización exige que coincida todo el prefijo renderizado. Para GPT-5.6 y versiones posteriores, el mínimo documentado es de 1.024 tokens. Una solicitud puede ser lógicamente equivalente a la anterior y aun así fallar si cambian las herramientas, el esquema, la configuración o los límites entre mensajes.
Eso modifica la pregunta de ingeniería. No preguntes solo si el proveedor admite caché. Pregunta si tu constructor de solicitudes produce un prefijo estable y observable que sobrevive a los cambios normales del producto.
Colocar primero el material estable
La disposición evidente también es la útil: instrucciones estables primero, herramientas compartidas y referencias después, y contenido específico del usuario o sensible al tiempo al final.
El orden no es cosmético. Una marca de tiempo al principio cambia el prefijo en cada llamada. Un identificador de tenant insertado en el mensaje de desarrollador puede impedir la reutilización entre solicitudes con las mismas instrucciones. Reordenar herramientas o cambiar un esquema JSON puede adelantar la primera diferencia aunque el comportamiento visible siga igual.
Trata la construcción del prompt como un payload de API con un serializador determinista. Da a la sección estable su propia función, versiónala y prueba su salida. Normaliza el orden de las herramientas. Mantén los identificadores generados, la hora actual y los datos de cada usuario después del límite reutilizable.
La conversación también importa. Añadir un mensaje conserva la secuencia anterior. Reescribir el último mensaje, resumir el historial o compactar el contexto puede cambiar los bytes anteriores y reducir la reutilización. OpenAI enumera las herramientas, el formato de salida estructurada, el nivel de razonamiento y la gestión de contexto entre los ajustes que pueden afectar al prefijo.
Por tanto, el límite correcto no es simplemente “el system prompt”. Es el prefijo más largo que puedes mantener idéntico sin mezclar datos que deben variar.
Un prefijo compartido necesita un breakpoint
Un prefijo estable es necesario, pero puede no bastar. El proveedor también necesita un punto elegible para escribir y buscar el estado almacenado.
OpenAI documenta breakpoints implícitos y explícitos. Si la primera solicitud escribe hasta un mensaje dinámico del usuario, otra solicitud con contenido distinto puede no encontrar un límite reutilizable después de las instrucciones estáticas. Un breakpoint explícito tras el bloque estable hace visible esa intención.
La referencia de prompt caching de Anthropic describe una regla relacionada. Coloca cache_control en el último bloque cuyo prefijo sea idéntico entre las solicitudes que quieres compartir. La búsqueda examina como máximo 20 posiciones de bloque por breakpoint. En una conversación creciente, un turno que añade muchos bloques pequeños puede dejar la escritura anterior fuera de esa ventana.
Estos detalles deben entrar en code review. Un refactor que combine bloques, divida el resultado de una herramienta o mueva un breakpoint puede cambiar la caché sin modificar la respuesta visible. Añade una prueba de forma de solicitud que registre el prefijo estable y los breakpoints de flujos representativos.
Separar la reutilización del aislamiento entre tenants
El prefijo más reutilizable no es automáticamente el más seguro para compartir.
OpenAI documenta prompt_cache_key para separar la contabilidad de caché por cliente o usuario. También señala que las claves separadas ayudan a impedir que un usuario sondee hits de otros. Las claves influyen en el enrutamiento, pero no fijan la solicitud a una máquina, por lo que no garantizan un hit.
Deriva el namespace de caché de la identidad autenticada cuando las solicitudes contengan material del tenant. No aceptes una clave arbitraria de un cliente no confiable. Mantén las instrucciones públicas reutilizables antes del límite específico del tenant cuando la interfaz lo permita y aísla el contexto privado de forma deliberada.
Esta es una decisión de arquitectura, no un truco de prompting. Documenta qué prefijo es público, qué parte pertenece al tenant y qué datos nunca deben entrar en una caché reutilizable según tu política de retención. Revisa esa clasificación cuando una herramienta nueva introduzca datos de cuenta en su esquema o descripción.
Medir el contrato, no la opción activada
Una caché activada que casi nunca acierta es una suposición de costes sin medir.
OpenAI expone los tokens leídos y escritos en los campos de uso. Anthropic informa de los tokens de lectura y creación y utiliza una duración predeterminada de cinco minutos, renovada cuando se usa el contenido. También ofrece una duración de una hora con coste adicional. La guía de context caching de Gemini indica que la caché implícita está habilitada para Gemini 2.5 y posteriores, mientras que los objetos explícitos requieren la API generateContent, no Interactions API.
Las interfaces cambian, pero el panel operativo debe responder las mismas preguntas:
- ¿Qué proporción de tokens de entrada vino de lecturas de caché?
- ¿Cuántos tokens se escribieron en la caché?
- ¿Cuál fue el coste real por flujo completado?
- ¿Mejoró el tiempo hasta la primera salida en los hits?
- ¿Qué cambio de forma o modelo movió la tasa de aciertos?
Agrega por versión del flujo y límite de tenant, no solo por producto. Una ruta de chat saludable puede ocultar otra que reescribe el prefijo en cada llamada. Registra operaciones completadas además de llamadas a API, porque los reintentos pueden volver caro un request individual barato.
Probar cambios con formas de solicitud registradas
Antes de cambiar de modelo, SDK o constructor, recopila solicitudes renderizadas representativas sin secretos. Registra la estructura ordenada de mensajes y herramientas, los tokens, los breakpoints y los ajustes relevantes.
Reproduce pares que deben compartir prefijo y pares que deben permanecer aislados. Confirma que el proveedor informa de las lecturas esperadas, en lugar de deducir el éxito por una latencia menor. Después prueba el comportamiento del producto. La caché no debería modificar la generación, pero una migración puede alterar a la vez la forma y el comportamiento del modelo.
En un agente, incluye las pausas incómodas. La ejecución de herramientas, una aprobación humana y un job en segundo plano pueden superar la duración de la caché. Cinco minutos pueden servir para una conversación activa y fallar en un flujo que espera a un operador. Pagar por una duración mayor solo ayuda cuando la reutilización esperada cubre el coste de escritura, así que mide la distribución real de pausas antes de elegirla.
Qué no cambia
Prompt caching no reduce los tokens de salida, garantiza respuestas idénticas ni elimina las evaluaciones. Tampoco convierte en útil un contexto sobredimensionado. Un prompt menor sin caché puede costar menos que rellenar un prefijo poco reutilizado hasta un umbral.
Tampoco sustituye la caché de la aplicación. Si una consulta autoritativa a la base de datos puede hacerse una vez y reutilizarse de forma segura, resuélvelo en la capa de datos. La caché del proveedor evita repetir el prefill del modelo. No establece frescura, autorización ni corrección para los hechos dentro del prompt.
El estándar práctico es limitado: construye un prefijo reutilizable y determinista, marca su límite, aísla el contexto de cada tenant y demuestra el resultado con tokens y latencia. Si no puedes observar esas cuatro propiedades, prompt caching sigue siendo una suposición en tu arquitectura.
Escrito por Dandelion Labs